📌MDFL论文实验
1. 选择数据集
作者没有直接使用真实车辆的摄像头或激光雷达数据,而是选择了 Fashion-MNIST,这是一个服饰图片分类数据集。
它包含:
- 10 个类别,例如衣服、鞋子、包等;
- 每个类别有 6000 张训练图片;
- 每个类别有 1000 张测试图片;
- 图片通常是 28×28 的灰度图。
所以整个任务是:车辆(客户端)利用各自拥有的服饰图片数据,共同训练一个分类模型。
2. 选择模型
作者选择经典的 LeNet 卷积神经网络(作为模型)进行分类。
每辆车的训练过程大致是:①接收当前的全局模型;②使用本地 Fashion-MNIST 数据训练 LeNet;③得到更新后的模型参数;④把模型参数发送给当前领导车辆;⑤由领导车辆进行模型聚合。
3. 模拟车辆移动性
论文构造了一个矩形道路区域,也就是它的研究范围,叫 RoI,可以理解为“当前参与训练的道路区域”。
本实验的tol设置区域如图所示:

rol的作用是:

然后用到了SUMO(全称是 Simulation of Urban MObility,中文通常叫“城市交通仿真平台”。)
SUMO为每辆车设置了下面东西:
①位置坐标 (x, y)
②速度 s
③加速度 a
4. 车辆信息设置
①-③上面sumo设置的3个信息。
④能耗:初始、本地训练、通信能耗

然后还有两种通信能耗,先简单介绍下,后面会详细讲:

⑤车辆直接通信半径

一轮联邦学习的能耗计算方法如下所示:

5. 对比方法
为了决定:①谁当领导车辆。②每辆车本地训练多少次。
MAPPO:论文方法,动态调度

Random:完全随机
DFL:所有车辆直接协作,固定训练策略

6. 评价指标
论文主要看两个指标:

7. 实验(图)
7.1 图1解释
①红色领导车辆把当前模型发给其他车辆;②每辆车拿到领导车辆的模型后,使用自己的本地数据进行训练。③本地训练完成后,普通车辆把训练后的模型发回领导车辆。④领导车辆收集各辆车的本地模型后,进行加权平均。⑤聚合完成后,领导车辆把新的聚合模型发给其他车辆。

7.2 图2解释

7.3 图3解释
用于解释直接通信与间接通信……

7.4 图4解释
论文设计了两类智能体:
①底部:每辆车一个本地训练次数选择器
②顶部:一个领导车辆选择器
普通车与领导车之间传输的东西是“位置、速度、加速度、剩余能量”。
普通车与普通车之间传输的东西是“位置、本地迭代次数”。
上传位置是为了计算位置距离,从而确定通信类别;上传本地迭代次数是为了让各个智能体了解各车状态,方便决定下次的本地训练次数。

7.5 图56解释
车辆一开始拥有多少能量,会怎样影响最终模型准确率?用来说明针对不用车辆能量,我论文中的客户端选择与本地轮次规定更能让acc好,且ecr也不差。

7.6 图78解释
间接通信能耗对实验结果的影响

7.7 图910解释
道路中车辆数量 N 增加时,三种方法最终模型准确率如何变化。【N是总车辆,不是参考训练的车辆】

7.8 图11解释
横轴是联邦训练轮数,纵轴是奖励值,奖励越高,说明 MAPPO 当前做出的调度越好

7.9 图12解释

Leader 选择奖励中的参数 \(\epsilon\) 取不同数值时,模型准确率如何变化。

7.10 图13解释
三列图,分别代表三种数据分布
先讲第二列图,这列图很好懂,x轴是客户端,y轴是样本数量,然后不同颜色表样样本的种类,从左到右越来越复杂!(①均匀。②每客户端只有少量种类。③完全模拟现实。)
然后开始讲第一列的,对比的是4种聚合方法,用来证明自己的客户端选择&本地训练轮次设置(MAPPO)能够适用于不同的聚类方法!

7.11 图14解释
与表3对应,是交通流预测实验的可视化结果。(本文的方法结果与实际上的差不多)
横轴:Time of Day,表示一天中的时间;
纵轴:Flow,表示交通流量;

8. 实验(表)
8.1 表1解释
与图12对应,研究的是奖励比例系数改变时,能耗指标是否稳定?

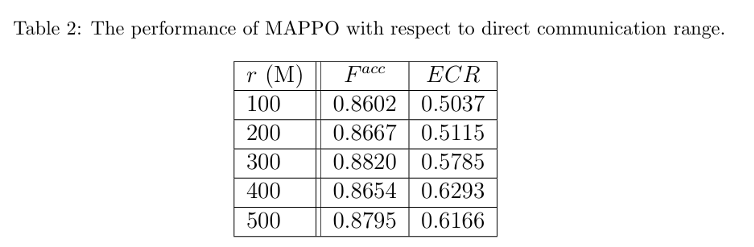
8.2 表2解释
研究的是直接通信半径对2类指标的影响……
8.3 表3解释
用交通流预测任务比较分布式 MAPPO 和集中式 CGRUL,结果显示 本文的MAPPO 预测误差与集中式CGRUL训练非常接近,说明该方法不仅能在 Fashion-MNIST 上运行,也有迁移到交通预测任务的能力。